25 - Intelligence artificielle
Apprentissage automatique
Un programme informatique a pour objectif de résoudre un problème dont on connaît la solution. Par exemple, le logiciel Pronote sait calculer la moyenne générale d’un élève à partir de toutes les notes entrées par les professeurs.
Pour les problèmes que l’on ne sait pas résoudre, comme par exemple la reconnaissance automatique des chiffres écrits à la main à partir d’une image scannée, on ne peut pas écrire de programme.
Mais, pour ces problèmes, il est facile d’avoir une base de données regroupant de nombreuses instances du problème considéré.
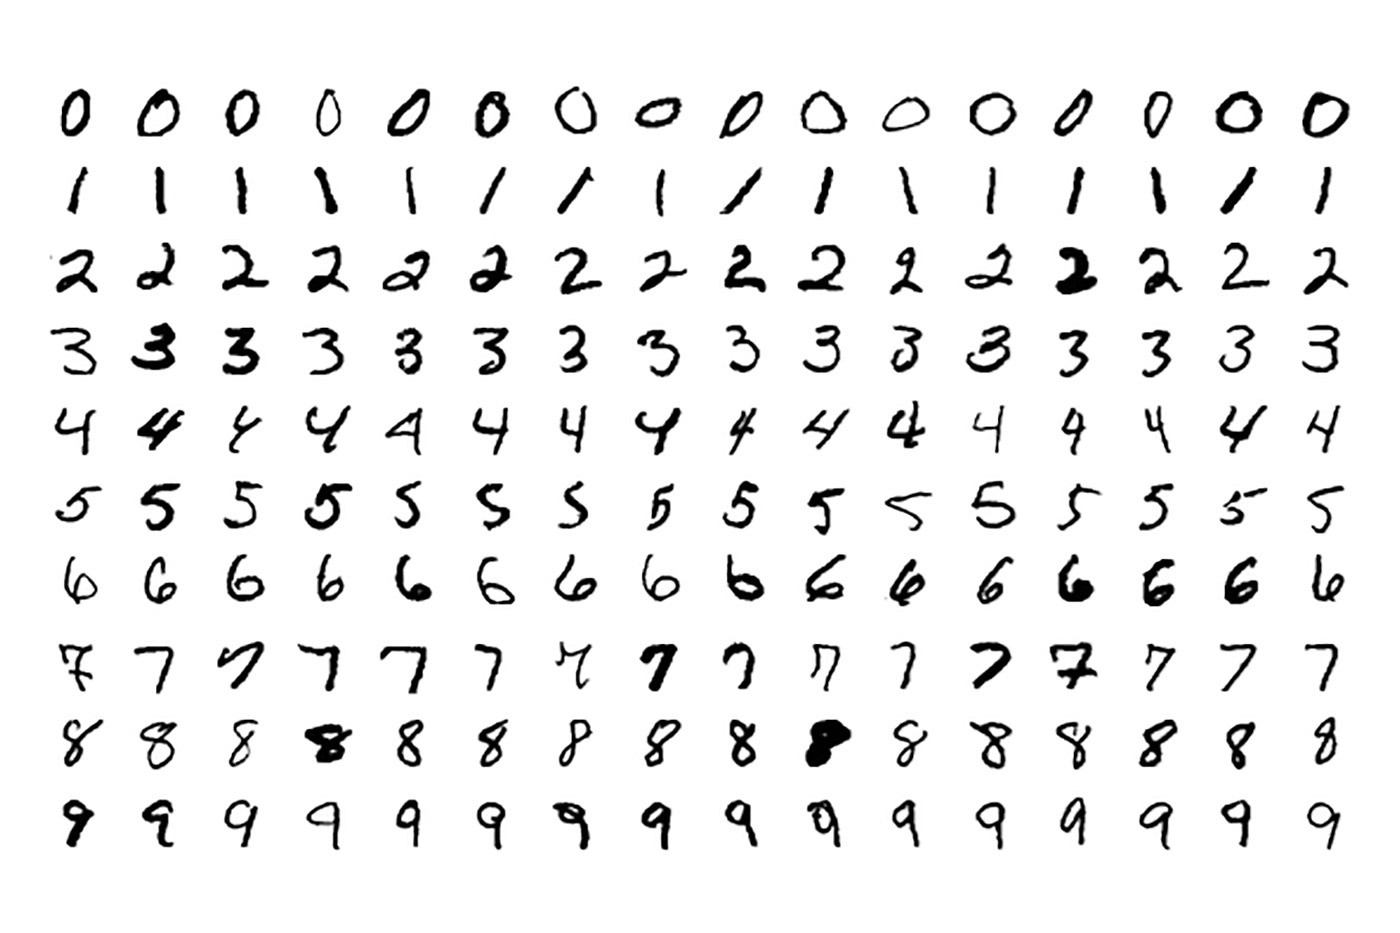
L’apprentissage automatique consiste alors à écrire un algorithme qui, à partir de données et d’expériences passées, va apprendre à résoudre « au mieux » un problème considéré.
Mode d’apprentissage
On distingue les algorithmes supervisés des algorithmes non supervisés.
Prenons un exemple d’images représentant des chats ou des chiens.
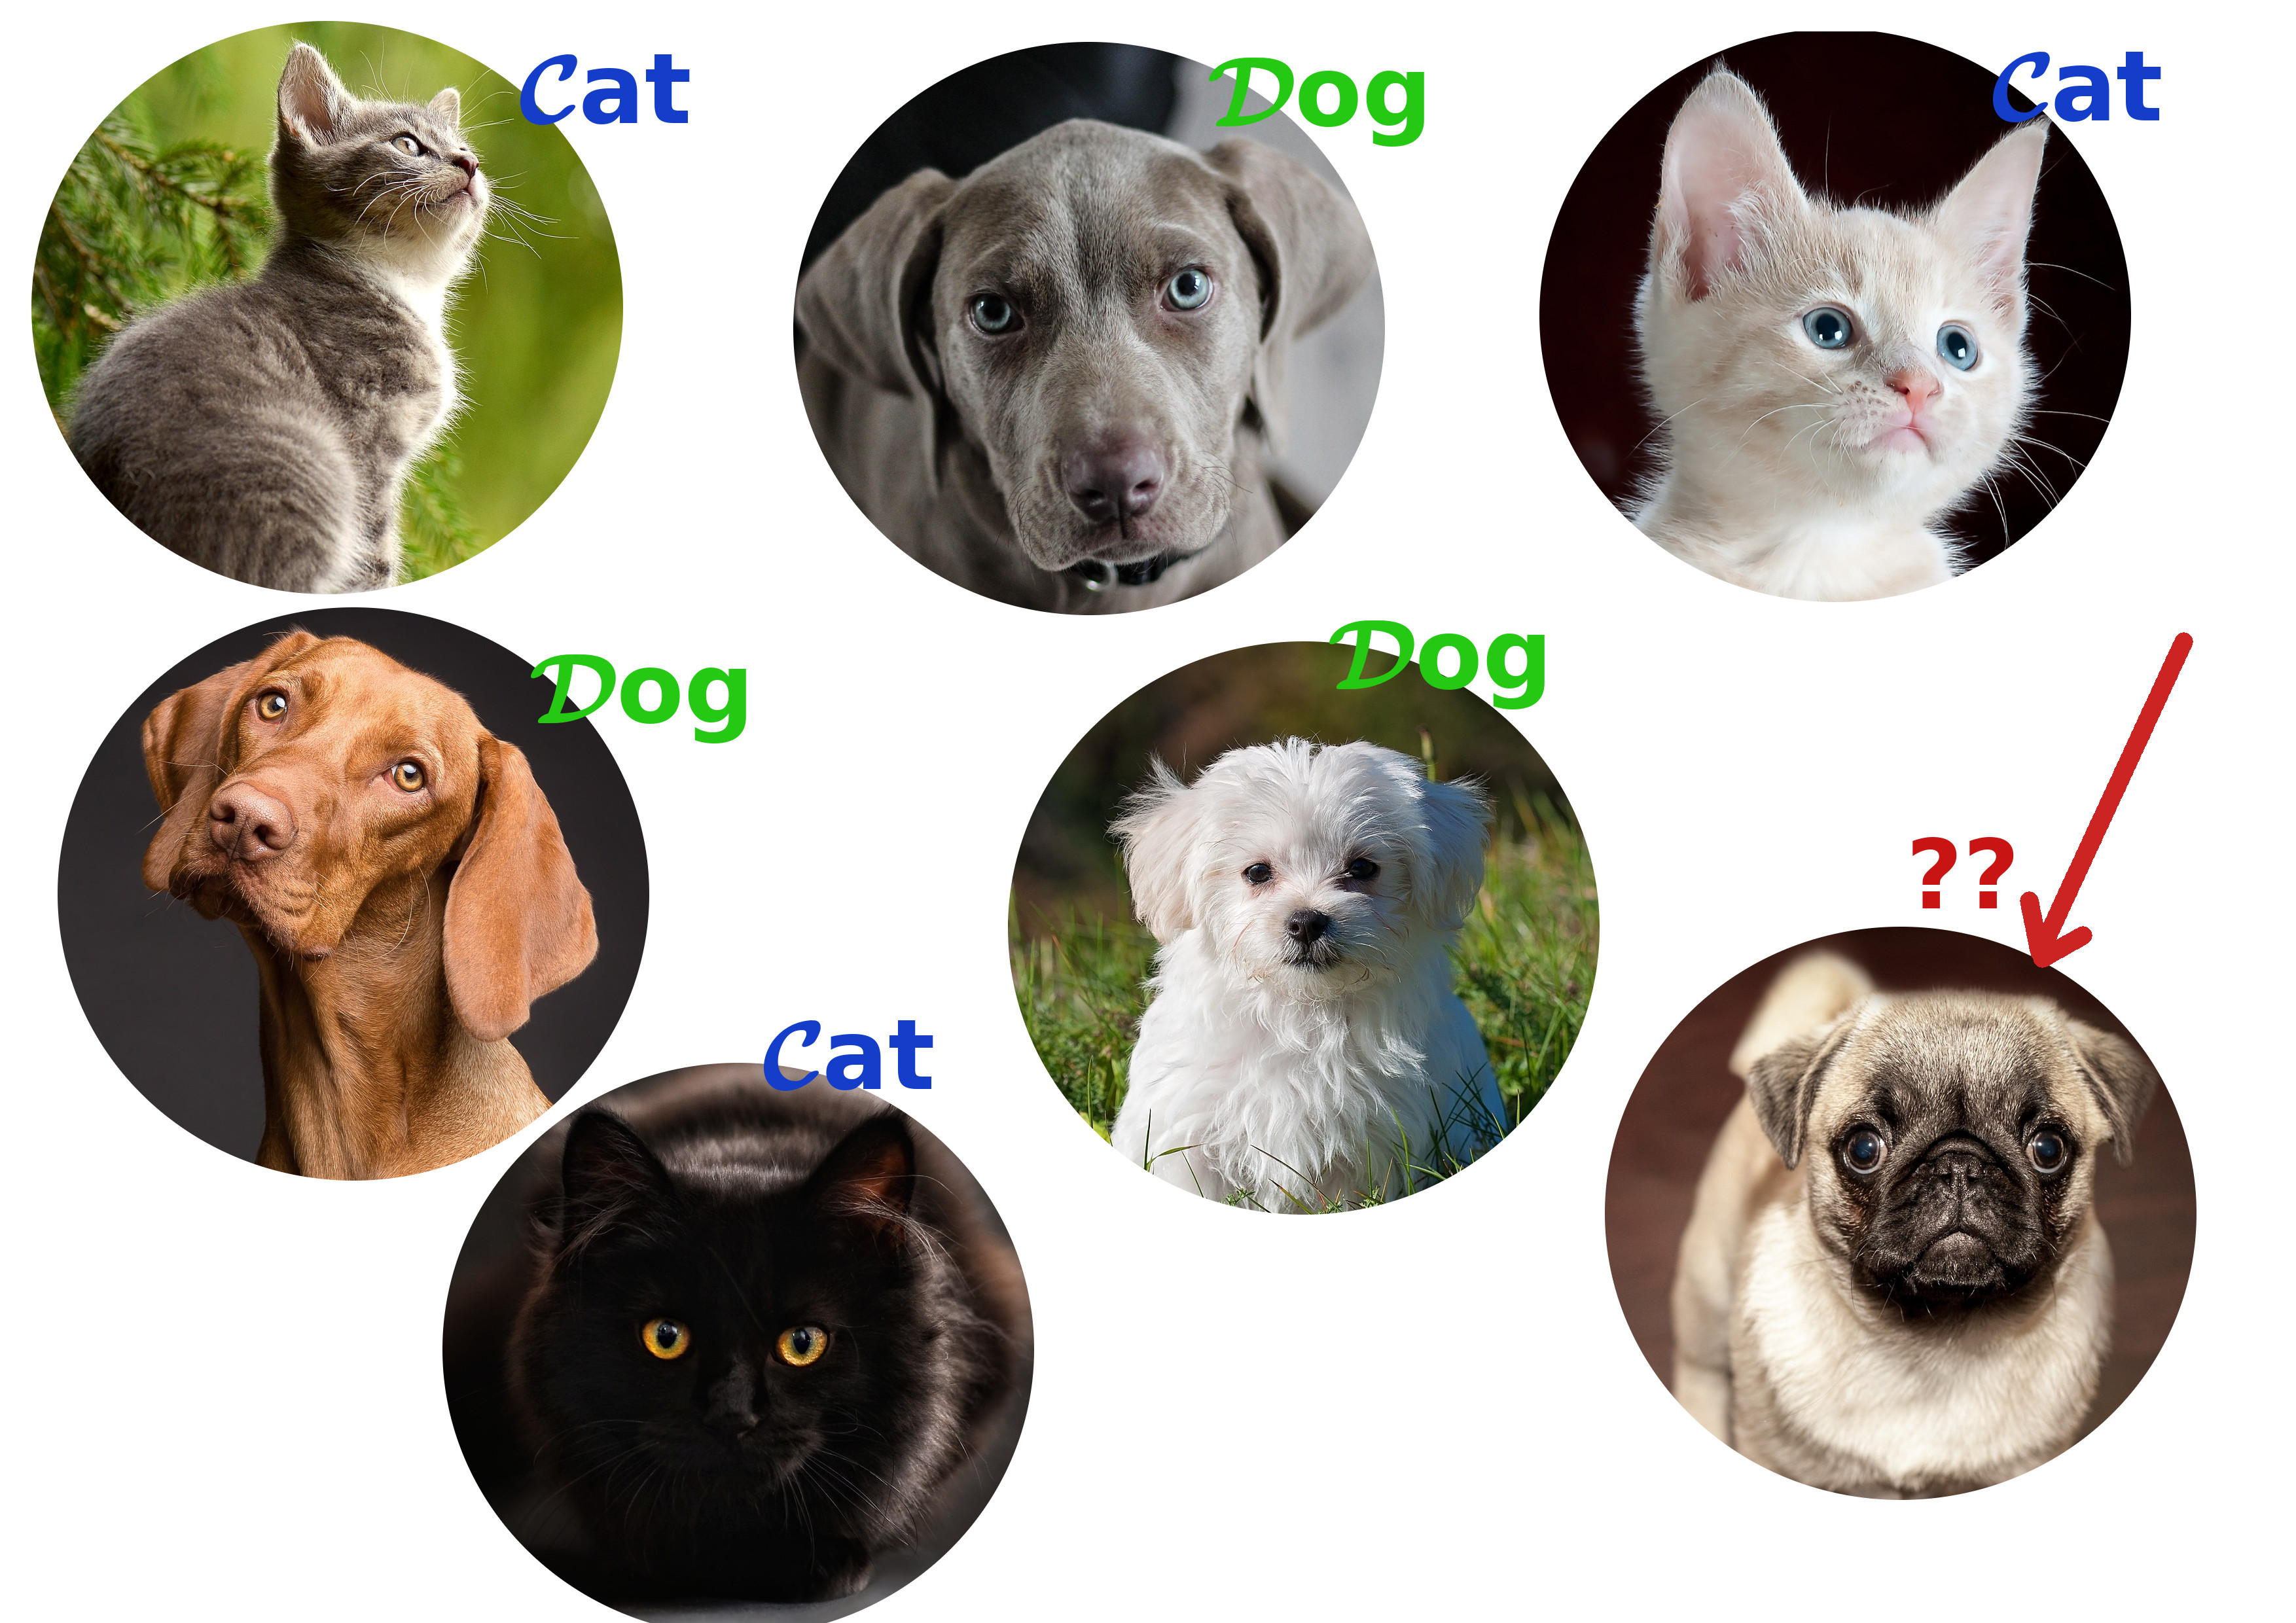
S’il s’agit d’un algorithme supervisé, c’est alors nous, humains, qui allons proposer les critères de classement (« chat » ou « chien »). Le nombre de classes est connu.
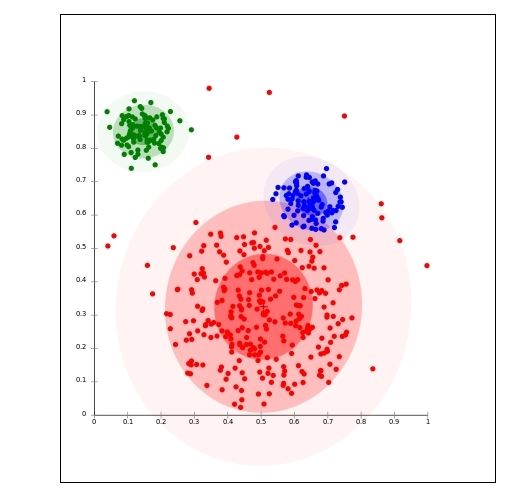
L’algorithme non supervisé doit par contre trouver lui–même les critères pour les organiser en groupe : on parle alors de clustering.
Type de problème
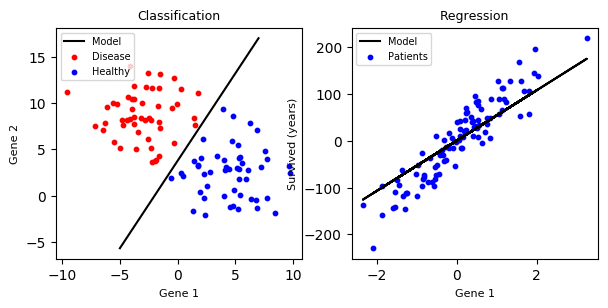
On distingue les algorithmes de régression de ceux de classification.
L’exemple précédent est un algorithme de classification : la nouvelle image à tester correspond à un chien ou un chat. Il n’y a pas de possibilité intermédiaire. On appelle cela une valeur discrète.
Un algorithme de régression permet, quant à lui, d’obtenir un nombre réel. Par exemple, à partir d’un échantillon contenant les données des habitations d’une ville (quartier, superficie, prix, etc.), l’algorithme sera en mesure de proposer un prix pour une nouvelle habitation.
Répartition des données
Entraîner un modèle, c’est ajuster pas à pas ses paramètres pour que ses prédictions se trompent le moins possible sur les exemples dont on dispose. À la fin de l’entraînement, on garde le modèle qui a donné les meilleurs résultats.
Reste à savoir si ce modèle est vraiment bon. On ne peut pas le juger sur les exemples qui ont servi à l’entraîner : il les a, en quelque sorte, appris par cœur. C’est comme un élève qui s’entraîne sur des exercices dont il a lu le corrigé : il les réussira tous, sans que cela prouve qu’il saura résoudre un exercice nouveau. Un modèle réussit toujours mieux sur ses exemples d’entraînement que sur des données nouvelles.
On partage donc les données en deux groupes dès le départ, avant tout entraînement.
Les données d’entraînement
C’est la plus grande part des données, généralement 80 %. Le modèle les utilise pour ajuster ses paramètres.
Les données de test
Ce sont les 20 % restants, mis de côté et jamais montrés au modèle pendant l’entraînement. Une fois le modèle terminé, on lui demande des prédictions sur ces données, puis on compare ses réponses aux vraies valeurs. Le taux d’erreur obtenu donne une idée honnête de ce que le modèle fera sur des données qu’il rencontrera plus tard en situation réelle.
Pour que cette mesure reste fiable, on ne modifie plus le modèle après avoir regardé son résultat sur les données de test : sinon, on finirait par l’adapter à ces données aussi.
Algorithmes d’apprentissage automatique
Supervisés
- Régression linéaire
- Régression logistique
- Classification naïve bayésienne
- Forêts d’arbres de décision
- Machine à vecteurs de support
- k plus proches voisins
Non supervisés
- Réduction de dimensionnalité Algorithme des k-moyennes (k-means)
On classe les données par groupes (clusters) de similarités. On utilise souvent la notion de distance pour faire ces regroupements.
Exemples d’applications
Médecine : soutien à la décision clinique pour le diagnostic médical
Finance : trading algorithmique (des millions de transactions par jour sans aucune intervention humaine)
Police : prévention des crimes et délits
Justice : aide à la décision dans les cas simples
Média : analyse de contenu multimédia audiovisuel
Musique et images : génération de morceaux, d’images et de vidéos à partir d’une description en langage naturel
Services client : assistants conversationnels (chatbots) fondés sur des modèles de langage
Jeux vidéo : navigation dynamique des personnages non joueurs
Transports : voitures autonomes
Éducation : parcours personnalisés d’apprentissage
Cybersécurité : prévention des attaques
Plateformes de streaming : recommandations personnalisées
GPS : anticipation des embouteillages
Traduction : analyse sémantique (le sens) d’une phrase
Les modèles de langage
Depuis 2022, les applications les plus visibles de l’apprentissage automatique sont les modèles de langage (large language models, LLM) tels que ChatGPT, Claude, Gemini ou Mistral. Un modèle de langage est un réseau de neurones entraîné sur des milliards de textes à une seule tâche : prédire le mot (plus précisément le jeton) le plus probable après ceux qu’il a déjà lus. Répétée mot après mot, cette prédiction produit des réponses, des traductions, des résumés ou du code.
Trois points à retenir :
- un modèle de langage ne consulte pas une base de faits : il génère une suite plausible, ce qui explique qu’il puisse affirmer avec assurance des choses fausses (on parle d’hallucinations) ;
- ses connaissances s’arrêtent à la date de ses données d’entraînement, sauf si on lui fournit des documents ou un accès à la recherche en ligne ;
- son entraînement demande des quantités considérables de données, de calcul et d’énergie, et pose des questions de droit d’auteur, de biais et de confidentialité.
On parle plus largement d’IA générative pour les modèles qui produisent du texte, des images, du son ou de la vidéo.
Algorithme des k plus proches voisins
L’algorithme des k plus proches voisins est un algorithme d’apprentissage supervisé. Il est souvent noté k-NN pour k-nearest neighbors en anglais.
Lorsqu’on exécute l’algorithme sur une nouvelle donnée, la méthode consiste à prendre en compte les k échantillons d’apprentissage les plus proches pour calculer le résultat. La classe majoritairement représentée sera choisie pour « classer » la nouvelle donnée.
Reprenons l’exemple des images de chiens ou de chats.
Choisissons
k = 5. Cela signifie que l’algorithme ne va prendre en compte que les cinq images dont les caractéristiques sont les plus proches de l’image à tester.Supposons que, parmi ces cinq images, trois sont celles de chats et deux celles de chiens, l’algorithme va donc considérer que la nouvelle image est celle d’un chat.
On dit parfois que l’on fait « voter » les plus proches voisins.
Dans cet algorithme k-NN, la notion de distance entre échantillons est primordiale et doit être définie en fonction des données et du fonctionnement attendu.
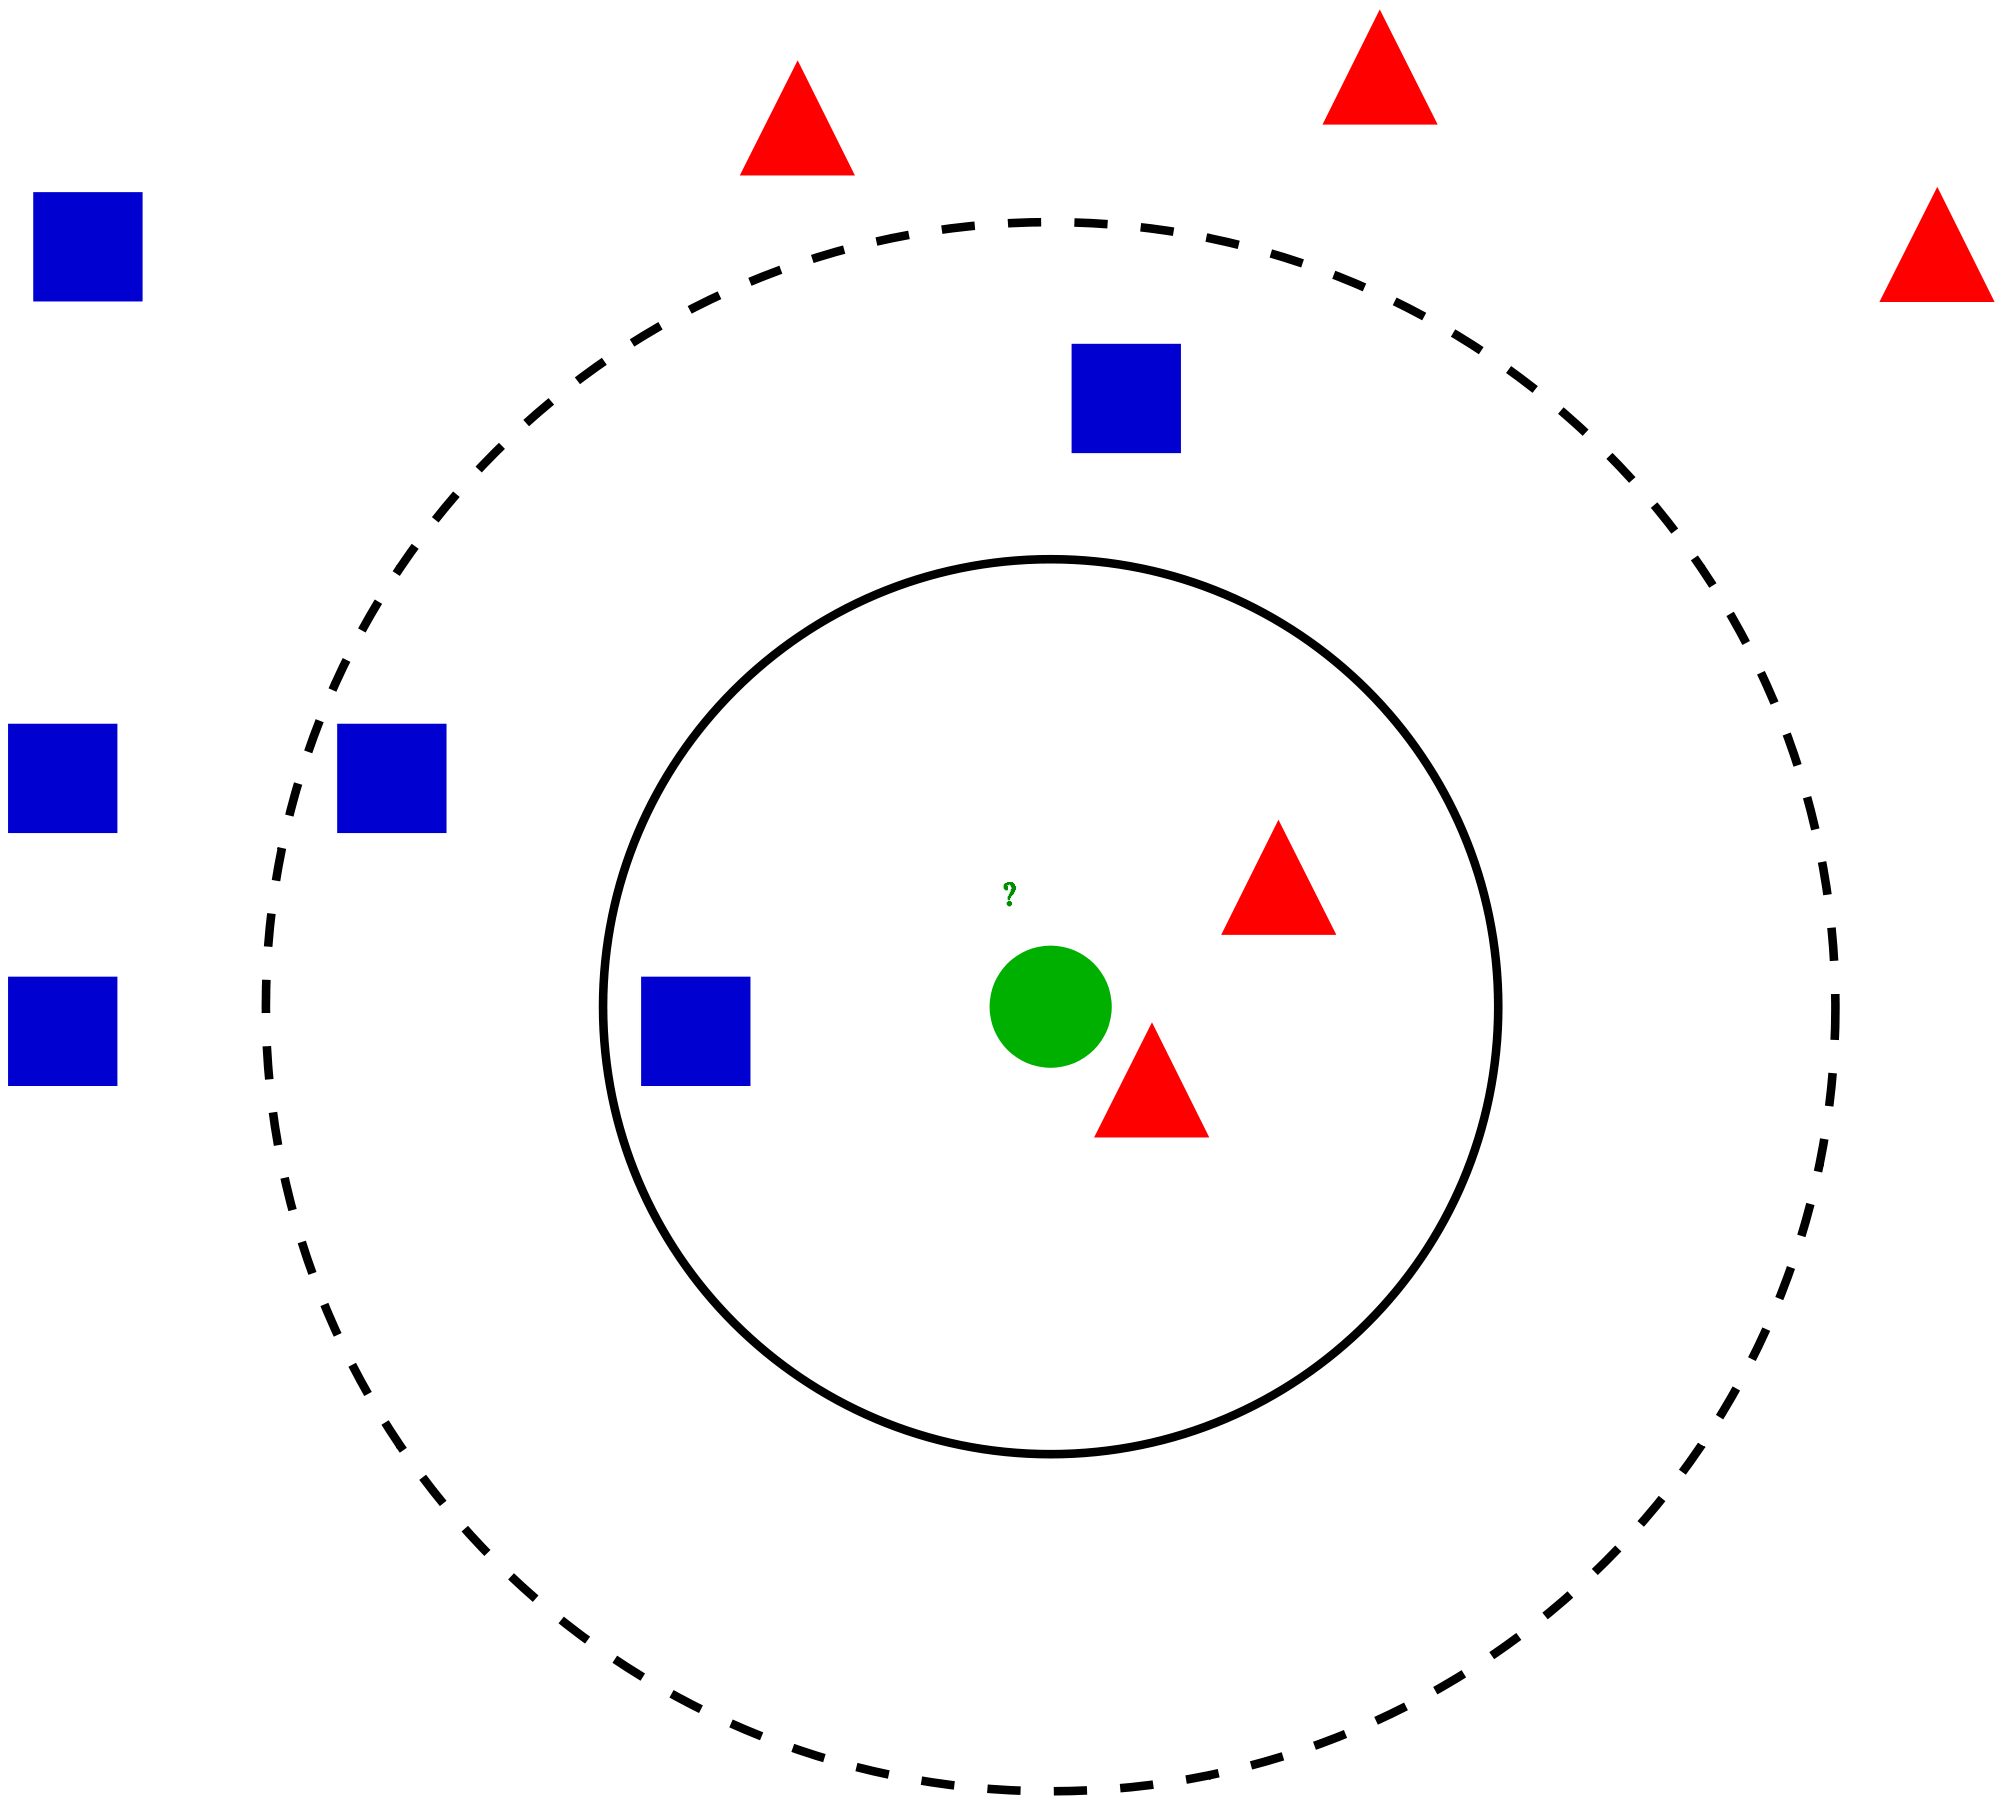
On remarque que si l’on choisit k = 3, l’algorithme classera plutôt la nouvelle image en tant que chien.
Une grande part de l’apprentissage automatique consiste donc à « entraîner » l’algorithme afin de minimiser les erreurs de prédiction.
Pour l’algorithme k-NN, cela consiste, entre autres, à :
ne choisir que les paramètres pertinents des données (est-il judicieux de prendre en compte le paysage de fond dans les photos de chats et de chiens ?) ;
choisir le meilleur nombre
kde voisins à faire voter (est-il judicieux de choisir unkpair ? unktrop petit ? unktrop grand ?) ;choisir la meilleure formule pour le calcul de la distance (euclidienne, de Manhattan, de Minkowski, de Tchebytchev, etc.).