06 - Textes
Introduction
Un texte se compose de mots, eux-mêmes composés de caractères qui en constituent la « particule élémentaire ». Ce sont donc les caractères que l’ordinateur doit savoir représenter pour retranscrire un texte : à chaque caractère, on associe un nombre, selon une convention appelée encodage.
Ce chapitre décrit les principaux encodages, du code ASCII à Unicode et UTF-8, explique comment un texte encodé avec l’un est mal lu avec l’autre, et montre comment Python passe des caractères aux nombres. Il se termine par la distinction entre texte simple et texte enrichi.
La représentation des textes simples
Pour représenter des caractères (lettres minuscules et majuscules, chiffres, signes de ponctuation, symboles mathématiques), le principe consiste à attribuer un nombre à chacun d’entre eux. Pour cela un code est utilisé.
Le code ASCII
Le code le plus connu (historique), est le code ASCII (American Standard Code for Information Interchange) conçu à l’origine pour des textes écrits en anglais. Ce code attribue par exemple le nombre 65 à la lettre « A » (41 en hexadécimal, 01000001 en binaire), le nombre 66 à la lettre « B », le nombre 97 à la lettre « a » et le nombre 98 à la lettre « b ». Il permet de représenter 95 caractères : les 26 lettres minuscules, les 26 lettres majuscules, les 10 chiffres, les 32 symboles de ponctuation et 1 signe d’espace. Il permet également de représenter 33 autres symboles de mise en page (retour chariot, saut de page, etc.).
Le code ASCII représente donc \(95 + 33 = 128 = 2^{7}\) caractères. Un codage en 7 bits devrait théoriquement suffire ; en réalité, chacun des nombres utilisés dans le code ASCII est codé en 8 bits (1 octet), le premier bit étant toujours zéro.
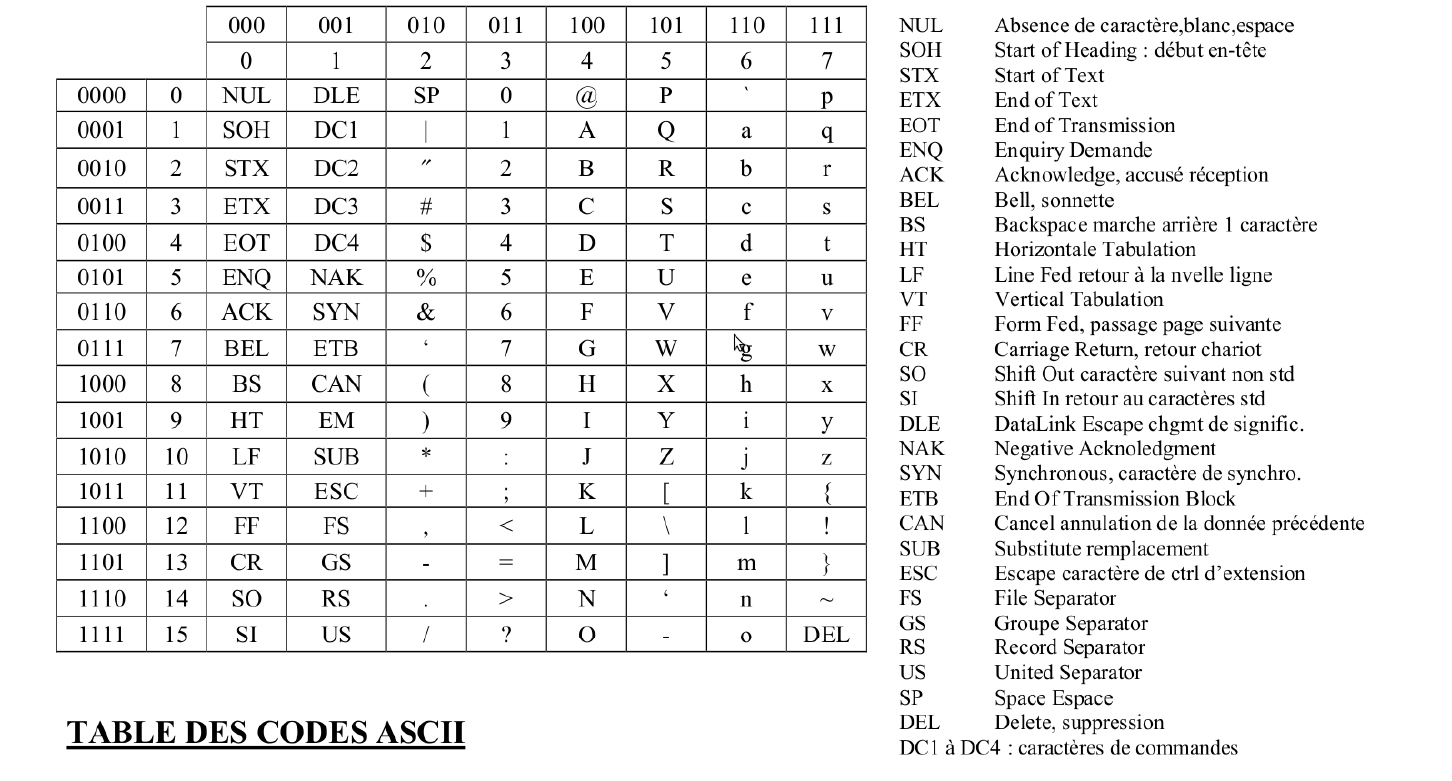
Méthode pour trouver la représentation en ASCII binaire d’un texte : en utilisant une table, on cherche le code ASCII de chaque caractère puis on traduit chacun des nombres obtenus en représentation binaire.
Méthode pour décoder un texte représenté en ASCII binaire : on découpe la suite de bits en octets, on traduit chaque octet en décimal puis on cherche le caractère correspondant dans une table ASCII.
Exercice 1. Trouver le texte représenté en ASCII binaire par la suite de bits suivante : 01001010 00100111 01100001 01100100 01101111 01110010 01100101 00100000 01101100 00100111 01101001 01101110 01100110 01101111 01110010 01101101 01100001 01110100 01101001 01110001 01110101 01100101 00100000 00100001
Exercice 2. Trouver le texte représenté en ASCII hexadécimal par : 4a 27 61 76 61 6e 63 65 20 64 61 6e 73 20 6d 6f 6e 20 70 72 6f 6a 65 74 20 64 65 20 4e 53 49 2e
Exercice 3. Coder la phrase en ASCII hexadécimal « Un âne est passé par là » (sans guillemets). Remarque ?
Le code ASCII étendu
Comme les ordinateurs rangent les caractères dans des octets de 8 bits, le huitième bit, toujours nul en ASCII, restait libre. Les constructeurs, IBM en tête, l’ont utilisé pour ajouter 128 caractères aux 128 de l’ASCII, soit 256 en tout : lettres accentuées, symboles mathématiques, et petits traits ou blocs servant à dessiner des cadres à l’écran.
Deux grandes familles de codes sur 8 bits se sont imposées :
- celle d’IBM, utilisée par le système DOS des premiers PC ;
- celle des normes internationales ISO 8859. Par exemple en Europe occidentale, c’est le code ISO-8859-1 (appelé aussi Latin-1, 191 caractères) qui est utilisé ; Windows en emploie une variante très proche, la page de code Windows-1252. D’autres variantes couvrent d’autres régions : ISO-8859-2 (Latin-2) pour l’Europe centrale, ou ISO-8859-15 (Latin-9), qui ajoute le symbole de l’euro à Latin-1.
Chaque système reprenait ainsi le code ASCII et proposait des extensions différentes selon la « page de code » retenue. Sous DOS, la page de code 850 était très employée en France et la page de code 864 définissait un jeu de caractères arabes ; sous Windows, les pages de code dites ANSI jouaient le même rôle, par exemple la page 1252 pour l’Europe occidentale et la page 1256 pour l’arabe. Un même octet pouvait donc désigner des caractères différents selon la page de code, source d’innombrables erreurs d’affichage.
Unicode
L’avènement de la mondialisation a conduit à la nécessité de construire un encodage de caractères le plus universel possible. C’est la norme ISO/CEI 10646 intitulée Technologies de l’information — Jeu universel de caractères codés (JUC) qui tente depuis 1988 de définir un système de codage universel pour tous les systèmes d’écriture.
L’idée est simple : une seule table pour toutes les écritures, ce qui rend les pages de code inutiles. Ses 128 premiers caractères sont exactement ceux de l’ASCII, si bien qu’un ancien texte ASCII reste valable. Chaque caractère y reçoit un nom unique et un numéro, appelé son point de code. La table compte aujourd’hui plus de 150 000 caractères : alphabets latin, grec, arabe, cyrillique, idéogrammes chinois, symboles mathématiques, émojis… Elle s’enrichit à chaque nouvelle version, avec des écritures anciennes ou rares et de nouveaux symboles.
Depuis 1991, le Consortium Unicode collabore avec l’ISO pour développer le Standard Unicode (« Unicode »). Chaque publication d’une nouvelle version d’Unicode donne ensuite lieu à une mise à jour de la norme, c’est-à-dire l’adjonction de nouveaux caractères et la mise à jour de ceux déjà présents.
Dans le standard Unicode, chaque caractère reçoit une identification numérique sous la forme U+xxxx (où xxxx est un nombre hexadécimal de 4 à 6 chiffres, entre U+0000 et U+10FFFF) : U+0041 pour « A », U+00E9 pour « é », U+20AC pour « € ». La plage définie permet d’attribuer jusqu’à 1 114 112 points de code.
Le point de code est un nombre ; reste à décider comment l’écrire en octets. Unicode existe pour cela en trois déclinaisons :
- avec UTF-32, chaque caractère occupe 32 bits, soit 4 octets, quel que soit le caractère ;
- avec UTF-16, chaque caractère occupe 1 ou 2 mots de 16 bits ;
- avec UTF-8, chaque caractère occupe de 1 à 4 octets. C’est la déclinaison la plus utilisée, car elle est rétro-compatible avec ASCII : les 128 caractères ASCII sont codés à l’identique sur un octet.
Les systèmes Unix, Linux et macOS utilisent UTF-8 par défaut ; Windows travaille en interne en UTF-16 mais lit et écrit couramment de l’UTF-8.
Exercice 4. Ouvrir un document texte en utilisant un éditeur de texte de votre choix (Google Docs, LibreOffice, Microsoft Word, Pages, etc.). Dans le menu « Insertion », cliquer sur « Caractères spéciaux » et donner le point de code Unicode des caractères suivants : é - € - @ - & - à
La table complète se trouve sur symbl.cc (le code est donné en hexadécimal : par exemple U+0041 pour la lettre A majuscule).
Le mécanisme UTF-8
UTF-8 découpe le point de code en morceaux répartis dans 1 à 4 octets. Les premiers bits de chaque octet indiquent son rôle : un octet qui commence par 0 est un caractère ASCII à lui seul ; un octet qui commence par 110, 1110 ou 11110 ouvre une séquence de 2, 3 ou 4 octets ; les octets suivants de la séquence commencent tous par 10.
| Point de code | Nombre d’octets | Forme binaire |
|---|---|---|
| U+0000 à U+007F | 1 | 0xxxxxxx |
| U+0080 à U+07FF | 2 | 110xxxxx 10xxxxxx |
| U+0800 à U+FFFF | 3 | 1110xxxx 10xxxxxx 10xxxxxx |
| U+10000 à U+10FFFF | 4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
Exemple : le caractère « é ». Son point de code U+00E9 vaut 233, soit 11101001 en binaire : il faut 2 octets. On répartit ses 11 bits (000 1110 1001, complétés par des zéros à gauche) dans les cases x de la forme 110xxxxx 10xxxxxx :
110 00011   10 101001
   C   3       A   9
« é » s’écrit donc C3 A9 en UTF-8, contre le seul octet E9 en Latin-1. Un emoji comme « 😀 » (U+1F600) occupe quatre octets : F0 9F 98 80.
Un texte mal décodé. Si un fichier écrit en UTF-8 est lu comme du Latin-1, les deux octets C3 A9 sont interprétés comme deux caractères, « à » et « © » : « été » s’affiche « été ». À l’inverse, un fichier Latin-1 lu comme de l’UTF-8 produit des caractères de remplacement « � ». Ces symptômes signalent toujours un décalage entre l’encodage d’écriture et l’encodage de lecture.
Malgré les efforts des comités de normalisation, il est donc parfois nécessaire de convertir un texte d’un encodage à un autre. Tous ces formats reposent sur la même idée : associer un nombre, c’est-à-dire un mot binaire, à chaque caractère.
En Python
Les fonctions ord et chr passent d’un caractère à son point de code (donné en décimal) et réciproquement :
ord(caractere): donne le point de code du caractère ;chr(numero): donne le caractère correspondant au point de code.
print(ord('B'))
print(chr(67))
print(f"{ord('é')} {hex(ord('é'))}")
66
C
233 0xe9
La méthode encode d’une chaîne de caractères donne ses octets dans l’encodage choisi, et la méthode decode d’une suite d’octets reconstitue la chaîne :
print("é".encode("utf-8"))
print("é".encode("latin-1"))
print(f'{len("été".encode("utf-8"))} {len("été".encode("latin-1"))}')
print(b"\xc3\xa9".decode("utf-8"))
print("été".encode("utf-8").decode("latin-1"))
b'\xc3\xa9'
b'\xe9'
5 3
é
été
Python affiche une suite d’octets entre b' et ' : la séquence \xc3 désigne un octet écrit en hexadécimal (ici l’octet C3), tandis qu’un octet qui correspond à un caractère ASCII affichable s’affiche directement sous la forme de ce caractère. Ainsi b'\xc3\xa9' est la suite des deux octets C3 A9.
La dernière ligne reproduit le défaut d’affichage décrit plus haut. Pour lire ou écrire un fichier texte, on précise toujours l’encodage ; convertir un fichier d’un encodage à l’autre tient en quelques lignes :
with open("texte-latin1.txt", encoding="latin-1") as source:
    contenu = source.read()

with open("texte-utf8.txt", "w", encoding="utf-8") as destination:
    destination.write(contenu)
Texte simple et texte enrichi
Les textes en ASCII ou en Unicode ne sont que des suites de caractères. Les logiciels de traitement de texte y ajoutent une mise en forme : police, taille, italique, gras, couleurs, titres, liens vers d’autres textes. Un texte qui porte ces informations est un texte enrichi, par opposition au texte simple. Un format enrichi repose sur des balises qui structurent et mettent en forme le contenu : c’est le principe du langage HTML des pages web, étudié dans la partie sur le web.
Les formats enrichis sont nombreux : les langages à balises GML (1969) puis SGML (1986), dont HTML (1990) et XML (années 1990) sont dérivés ; le format RTF (1987), lisible mais limité ; les formats de bureautique fondés sur XML, OpenDocument (norme ISO en 2006, fichiers .odt de LibreOffice) et Office Open XML (2006, fichiers .docx, .xlsx et .pptx) ; enfin \(\TeX{}\), présenté en annexe.
Annexe : un exemple de document LaTeX
En 1977, l’informaticien Donald Knuth, mécontent de la mise en page des nouvelles éditions de son livre The Art of Computer Programming, décide d’écrire son propre logiciel de composition : \(\TeX{}\). On y écrit le texte entouré de commandes qui décrivent sa mise en forme, et il excelle dans l’écriture des formules mathématiques. Avec sa version simplifiée \(\LaTeX{}\), il reste l’outil de référence des scientifiques. C’est un langage de mise en forme : il sert à produire un document bien présenté, pas à stocker ou échanger des données.
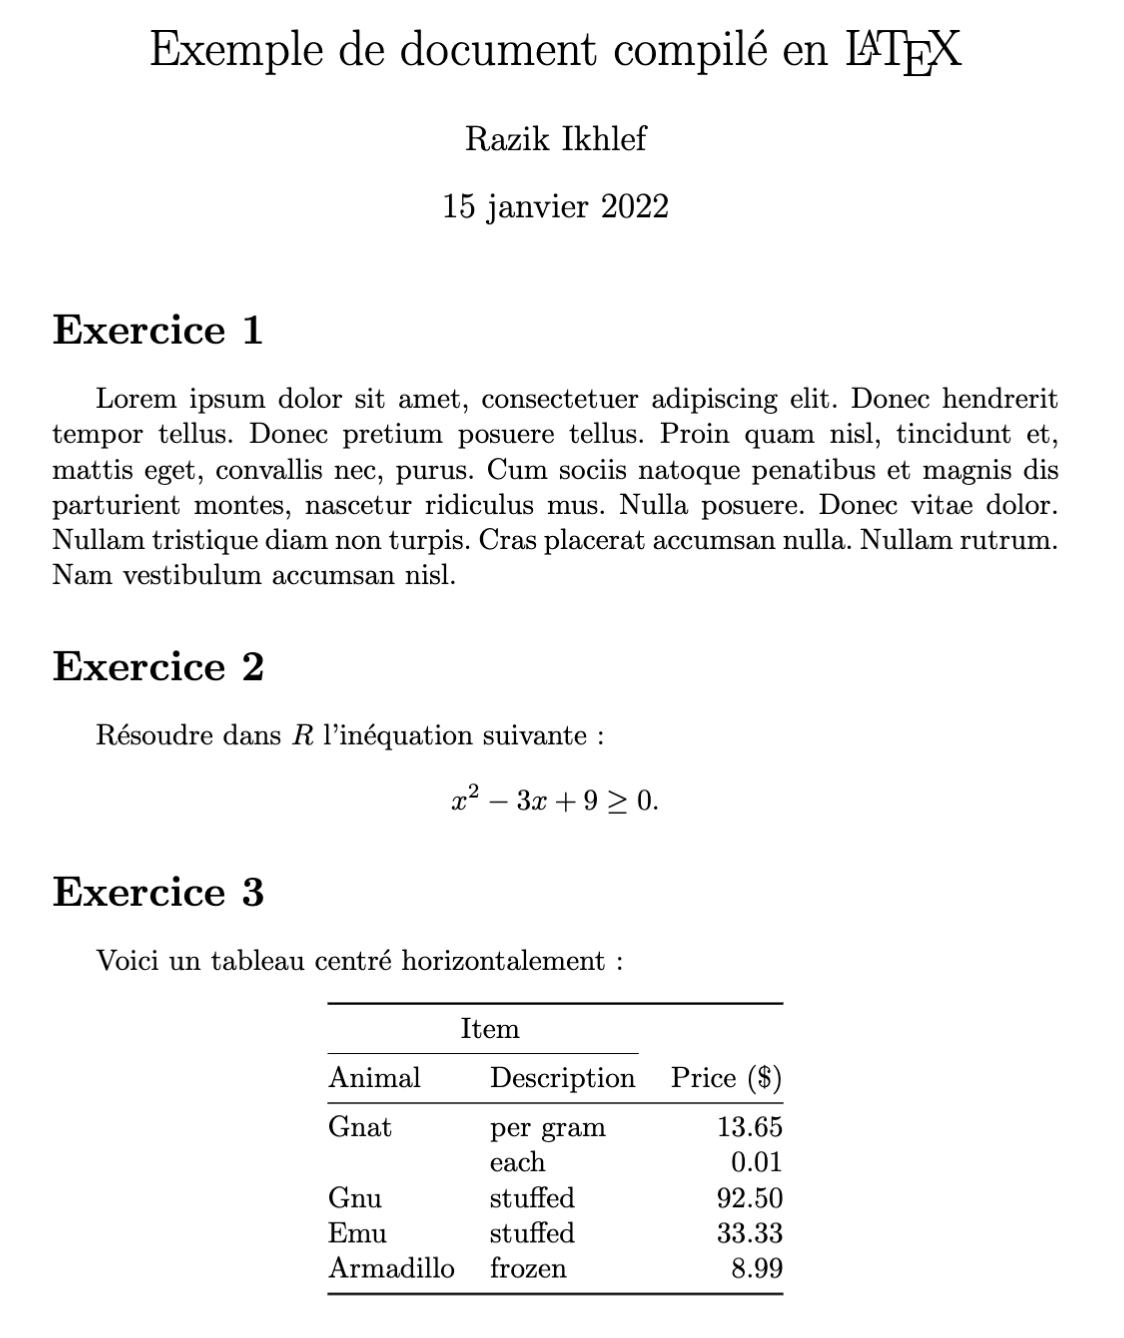
Le document \(\TeX{}\) suivant…
\documentclass{article}
\usepackage[utf8]{inputenc}
\usepackage[french]{babel}
\usepackage{amsmath}
\usepackage{amssymb}
\usepackage{booktabs}

\title{Exemple de document compilé en \LaTeX}
\author{Razik Ikhlef}
\date{\today}

\begin{document}

\maketitle


\section*{Exercice 1}
Lorem ipsum dolor sit amet, consectetuer adipiscing elit.  Donec hendrerit tempor tellus.  Donec pretium posuere tellus.  Proin quam nisl, tincidunt et, mattis eget, convallis nec, purus.  Cum sociis natoque penatibus et magnis dis parturient montes, nascetur ridiculus mus.  Nulla posuere.  Donec vitae dolor.  Nullam tristique diam non turpis.  Cras placerat accumsan nulla.  Nullam rutrum.  Nam vestibulum accumsan nisl.

\section*{Exercice 2}
Résoudre dans $\mathbb{R}$ l'inéquation suivante : \[x^2-3x+9\geq0.\]


\section*{Exercice 3}
Voici un tableau centré horizontalement :

\begin{center}

\begin{tabular}{@{}llr@{}} \toprule
\multicolumn{2}{c}{Item} \\ \cmidrule(r){1-2}
Animal & Description & Price (\$)\\ \midrule
Gnat & per gram & 13.65 \\
& each & 0.01 \\
Gnu & stuffed & 92.50 \\
Emu & stuffed & 33.33 \\
Armadillo & frozen & 8.99 \\ \bottomrule
\end{tabular}

\end{center}

\end{document}
… donne le PDF suivant après compilation :
Pour ceux qui veulent en savoir plus :
Il est possible de créer un compte gratuitement sur la plateforme Overleaf pour s’entraîner (utiliser votre compte Google CSI) :